La supervision informatique externalisée consiste à confier à une équipe extérieure la surveillance de vos applications et de votre infrastructure : collecte des métriques, des journaux et des traces, gestion des alertes, premier diagnostic, correction ou escalade, et amélioration continue. Elle apporte le plus quand cette équipe connaît les applications qu’elle surveille, et quand les règles du jeu sont écrites : ce qui est surveillé, à quelles heures, avec quels délais d’intervention et qui décide. Voici comment l’organiser, et ce que nous faisons chez Etixio.
Ce qu’on appelle supervision en 2026
La supervision ne se limite plus à vérifier qu’un serveur répond. Sur une architecture actuelle (cloud, conteneurs, services managés, API tierces, services IA), on parle plutôt d’observabilité : la capacité à comprendre ce qui se passe dans le système à partir de trois types de signaux.
- Les métriques : temps de réponse, taux d’erreur, débit, saturation des ressources.
- Les journaux : ce que l’application et l’infrastructure écrivent, centralisés et consultables.
- Les traces : le parcours d’une requête à travers les services, pour trouver où elle ralentit ou échoue.
OpenTelemetry s’est imposé comme le standard ouvert pour collecter ces signaux. Côté outils, les choix courants sont Prometheus et Grafana, Zabbix ou Centreon pour l’infrastructure classique, ou des plateformes commerciales comme Datadog. Le bon outil est souvent celui que vous avez déjà, correctement réglé.
Superviser ce qui compte pour vos utilisateurs
L’erreur la plus fréquente est de surveiller beaucoup de choses et d’être alerté trop souvent. Une supervision utile part des parcours métier :
- Les parcours critiques : connexion, commande, paiement, saisie d’un dossier, export. Sont-ils disponibles et rapides ?
- Les indicateurs de service : taux d’erreur, temps de réponse au 95e centile, files en attente, tâches planifiées exécutées.
- Les échéances : certificats, noms de domaine, licences, quotas d’API.
- Les ressources : processeur, mémoire, disque, connexions à la base de données.
- Les sauvegardes : exécutées, complètes, et restaurées au moins une fois pour vérifier qu’elles fonctionnent.
- Les coûts cloud et, pour les services IA, la consommation et la qualité des réponses (voir LLMOps et évaluation IA).
Chaque alerte doit appeler une action. Si personne ne sait quoi faire quand elle se déclenche, elle doit être supprimée ou accompagnée d’une procédure. Exemple de règle d’alerte Prometheus, liée à une procédure écrite :
groups:
  - name: api
    rules:
      - alert: TauxErreurApiEleve
        expr: |
          sum(rate(http_requests_total{job="api", status=~"5.."}[5m]))
            / sum(rate(http_requests_total{job="api"}[5m])) > 0.05
        for: 10m
        labels:
          severity: critique
        annotations:
          summary: "Plus de 5 % d’erreurs serveur sur l’API depuis 10 minutes"
          runbook_url: https://wiki.example.com/procedures/api-erreurs
Supervision informatique externalisée : ce que vous confiez, ce que vous gardez
À confier : la mise en place et le réglage des outils, le suivi quotidien des alertes, le premier diagnostic, les corrections sur les applications que le prestataire maintient, les mises à jour et correctifs de sécurité planifiés, les rapports et l’analyse des tendances.
À garder : les priorités, les arbitrages entre risque et coût, la validation des changements sensibles, la relation avec vos utilisateurs et vos fournisseurs, et la propriété de tout ce qui a été mis en place.
La propriété est un point clé. Les outils, les tableaux de bord, les règles d’alerte, les procédures et l’historique des incidents doivent être dans vos comptes et vos dépôts. Si vous changez de prestataire, vous reprenez tout.
Définir les niveaux de service
Un contrat de supervision sérieux répond par écrit à quelques questions :
- Quelles plages horaires sont couvertes ? Heures ouvrées, plage étendue, astreinte le soir ou le week-end : chaque option a une organisation et un coût différents.
- Quels délais ? Délai de prise en charge et objectif de résolution, par niveau de gravité.
- Quelle escalade ? Qui est prévenu, par quel canal (courriel, Teams, Slack, téléphone), et qui décide d’un retour arrière.
- Quels objectifs de fiabilité ? Pour les services critiques, des objectifs explicites (disponibilité, temps de réponse) mesurés sur la durée, plutôt qu’une promesse générale.
- Quel compte rendu ? Rapport régulier, revue des incidents, actions décidées.
Méfiez-vous des promesses de disponibilité « quasi totale » ou d’économies chiffrées avant même d’avoir vu votre système. Un niveau de service se construit à partir de votre existant, de la criticité de chaque application et de ce que l’équipe peut réellement tenir.
Supervision et sécurité
La supervision contribue à la sécurité : elle repère des comportements anormaux, des pics d’erreurs d’authentification, des ressources consommées sans raison. Elle ne remplace pas pour autant un centre opérationnel de sécurité (SOC), qui demande des outils et des compétences spécifiques. Nous recommandons de relier les deux : les alertes de sécurité de la supervision alimentent votre dispositif de sécurité, et les correctifs sont appliqués dans des délais définis. Ces sujets s’inscrivent dans un programme cybersécurité et conformité.
Comment nous travaillons chez Etixio
Chez Etixio, la supervision fait partie de notre offre DevOps & Cloud Management. Elle porte en priorité sur les applications que nous développons ou maintenons pour vous, et sur l’infrastructure qui les fait tourner. Si vous le souhaitez, nous assurons l’exploitation au quotidien : supervision, correctifs, mises à jour et amélioration continue, avec un niveau de support, des horaires et des délais d’intervention définis ensemble.
Concrètement :
- État des lieux : applications, environnements, outils déjà en place, incidents récents, risques. C’est souvent l’objet d’un audit technique.
- Mise en place : collecte des métriques, journaux et traces, tableaux de bord, alertes reliées à des procédures, dans vos comptes cloud et vos outils.
- Exploitation : suivi des alertes, diagnostic, correction ou escalade selon les règles convenues, post-mortem après chaque incident significatif.
- Amélioration continue : réglage des seuils, suppression des alertes inutiles, automatisation des corrections récurrentes, revue régulière avec vos équipes.
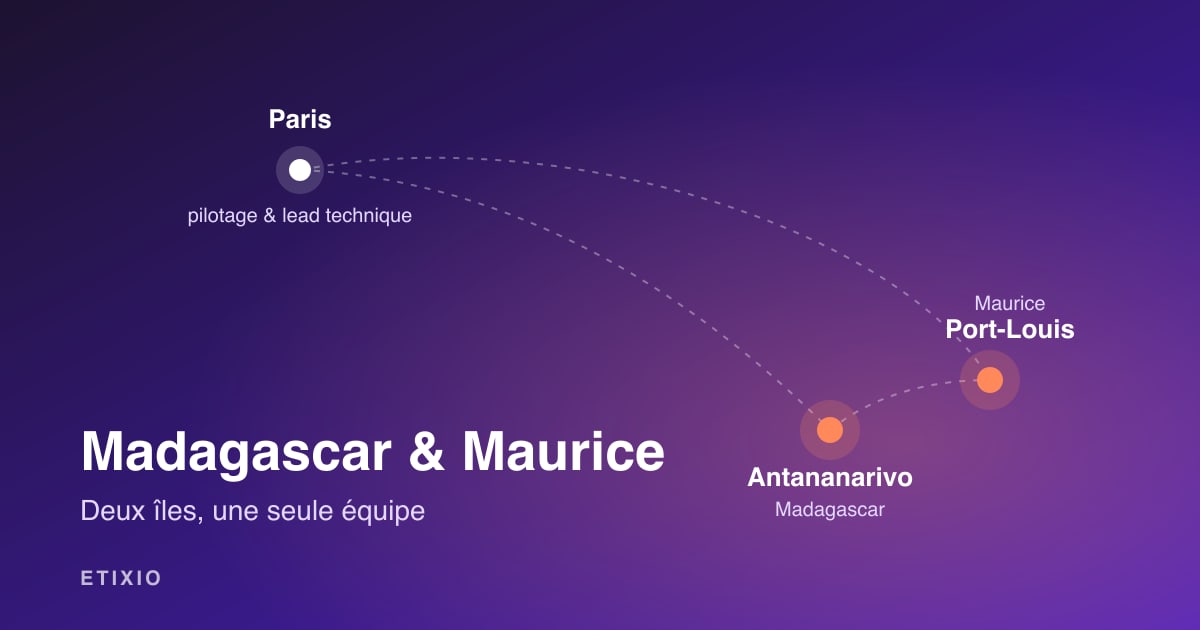
Le travail est porté par nos ingénieurs francophones à Madagascar et à Maurice, encadrés par nos leads techniques, responsables de la qualité et de la continuité : documentation à jour, procédures écrites, transmission organisée. Madagascar est à UTC+3 et Maurice à UTC+4 : nos équipes commencent leur journée une à trois heures avant Paris, ce qui permet de traiter les alertes de la nuit et de faire les premiers diagnostics avant l’arrivée de vos équipes. Toute couverture au-delà des horaires de travail se définit explicitement au contrat.
Votre code, vos accès, vos outils : tout reste à vous. Nos équipes travaillent dans votre environnement, avec vos règles, et vous pouvez reprendre la main à tout moment.
Vous voulez fiabiliser l’exploitation d’une application ou organiser sa supervision ? Présentez-nous votre environnement : nous commencerons par un état des lieux.
Supervision informatique externalisée : questions fréquentes
Pourquoi externaliser la supervision informatique ?
Pour disposer de compétences d’exploitation (outils de supervision, alertes, diagnostic) sans les construire entièrement en interne, et pour que la surveillance de vos applications soit tenue par des personnes qui les connaissent. L’intérêt est le plus fort quand le prestataire développe ou maintient déjà ces applications : il sait quoi surveiller et comment corriger.
Que faut-il superviser en priorité ?
Ce que vivent vos utilisateurs avant l’état des machines : disponibilité et temps de réponse des parcours critiques, taux d’erreur, files de traitement, tâches planifiées, certificats et échéances. Viennent ensuite les ressources (CPU, mémoire, disque, base de données), les sauvegardes et les coûts cloud.
Quel niveau de service prévoir ?
Il se définit selon la criticité de chaque service : plages horaires couvertes, délais de prise en charge et de résolution par niveau de gravité, circuit d’escalade, astreinte éventuelle. Chez Etixio, le niveau de support, les horaires et les délais d’intervention sont définis ensemble et écrits dans le contrat ; nous ne promettons pas de couverture que nous n’avons pas organisée.
Externaliser la supervision fait-il perdre le contrôle du système d’information ?
Non, si la gouvernance est claire. Les outils, les tableaux de bord, les accès et l’historique des incidents restent chez vous ; vous fixez les priorités et validez les changements. Le prestataire travaille dans votre environnement, avec vos règles, et vous rend compte régulièrement. Voir notre article sur la gouvernance d’une équipe IT offshore.
Combien coûte une supervision informatique externalisée ?
Le coût dépend du périmètre (nombre d’applications et d’environnements), des plages horaires couvertes, des délais d’intervention attendus et des outils déjà en place. Nous le chiffrons après un état des lieux de votre existant, plutôt qu’avec un tarif générique.
Quel est l’intérêt d’équipes à Madagascar et à Maurice pour la supervision ?
Nos équipes y travaillent en français, à UTC+3 (Madagascar) et UTC+4 (Maurice), soit 1 à 3 heures d’avance sur Paris selon la saison. Leur journée commence avant la vôtre : les contrôles du matin, le traitement des alertes de la nuit et les premiers diagnostics peuvent être faits quand vos équipes arrivent. Pour une couverture étendue, les horaires se définissent au contrat.